教程
教程
后端、跨平台、AI编程
共 110 篇RSS
AI 生成的活动海报为什么都长一个样?把设计流派的名字说出来就能跳出模板
英国一个社区集市的海报被 AI 做成了同一个模板,作者拿 ChatGPT 做了一组实验:只要指定具体的设计流派,哪怕只是说出风格的名字,产出立刻拉开差距。
把 35KB 的提示词从 Claude、OpenAI 搬到自托管 Ollama:踩过的坑和该盯住的失败信号
在 frontier API 上跑得好好的大提示词,换到本地 27B 模型上三分钟就开始打转:反复读同一个文件、重写已经完成的工作。作者把这次迁移的经验整理成一套可操作的调整清单,包括单目标提示、显式设置 ollama 上下文长度,以及几类判断上下文耗尽的失败信号。
用 Rust 的 rmcp 写一个 MCP server:从空项目到接进编码助手
一份可以照着敲的完整教程:用 rmcp 0.11 搭起 MCP server 骨架,接上本地的 CRUD API,写两个工具(一个只读、一个带参数),用 MCP Inspector 验证,最后配进 Kiro CLI 真跑一遍。
别把 LLM 当分类器,把它的判断当特征
让 LLM 直接输出标签,校准、阈值控制、对结构化数据的利用、可解释性全都会失控。把它的判断当成一个特征喂给逻辑回归,这些性质就都回来了;再叠上 LLM 抽取的特征和一批规则特征,讽刺识别任务的 Brier 分数从 0.259 降到 0.127,F1 从 0.747 提到 0.779。
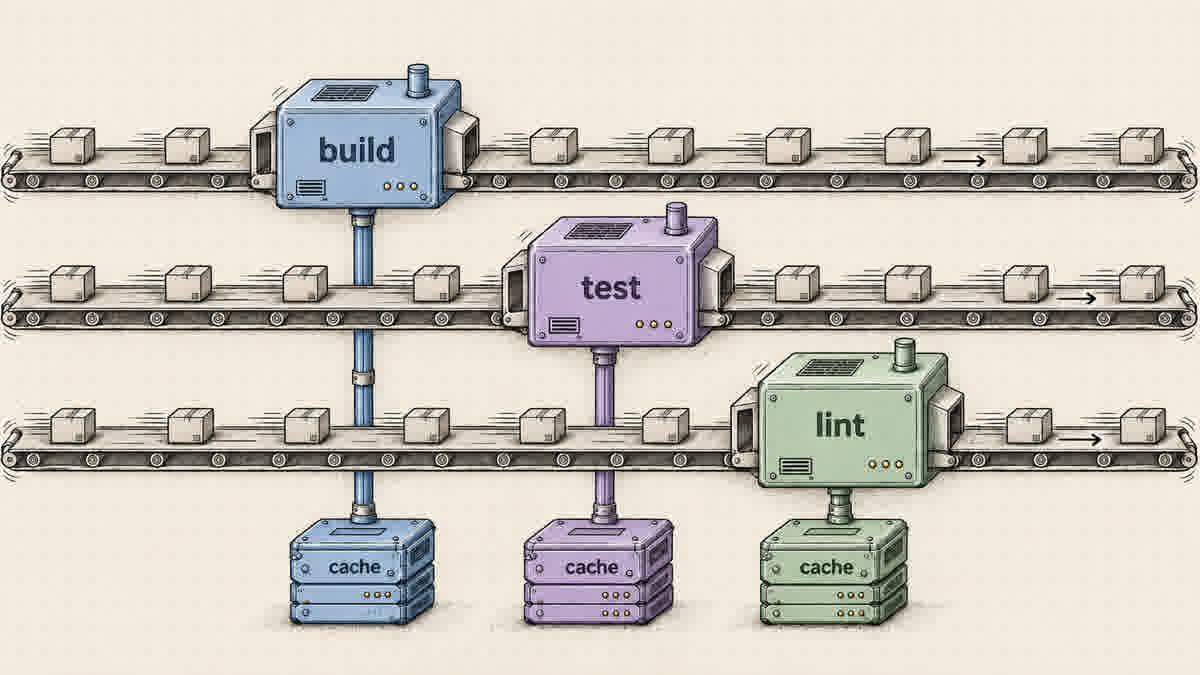
换掉官方 actions/setup-go,Go CI 测试耗时缩短 69%
CloudX 团队发现官方 actions/setup-go 的缓存 key 设计有缺陷:并行任务会互相覆盖缓存,测试任务因此越跑越慢。他们重写了一个 drop-in 替代品并开源,测试任务中位耗时从 131 秒降到 41 秒。
MinIO 停更后本地 S3 存储该换谁:7 个候选方案的实测结果与避坑点
MinIO 被原公司放弃后,所有靠它模拟 S3 的本地演示环境都得换人。作者用同一套 DuckDB 加 Iceberg 的栈逐个替换测试,给出配置难度、许可证、社区健康度的横向对比。
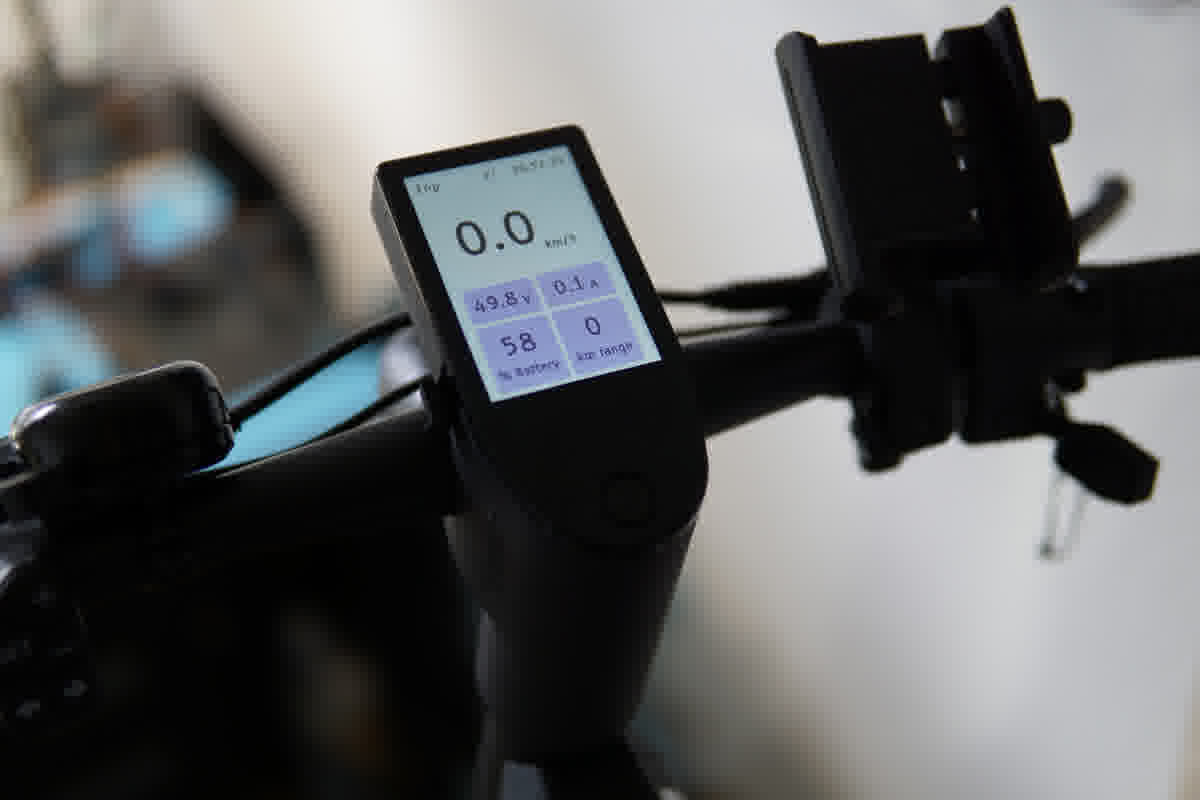
电动滑板车逆向实战:嗅探 CAN 总线、Ghidra 拆固件,用 Rust 重写显示屏程序
一位开发者拆开自己的电动滑板车做逆向:从发现 USB-C 口其实是 CAN 总线,到用 Ghidra 还原通信协议、搞清一个免鉴权的固件更新流程,最后给只有 32KB 内存的显示屏 MCU 写了一套 Rust 固件。
15 分钟完成第一次 OpenStreetMap 编辑:给身边的小店补上官网标签
一份可以照着做的 OpenStreetMap 入门教程:用 JOSM 配合 Website Wizard 插件,15 分钟内给附近商铺补上官方网站标签。
OpenRouter 实战避坑:同一个模型,换个 Provider 就像换了另一个模型
同一个 DeepSeek V4 Flash,不同 Provider 的 TAU-Bench 成绩能差二十多个百分点。一位处理过 1800 万条消息的开发者,把用 OpenRouter 踩过的 10 个坑整理成了清单。
vLLM 投机解码实战:方法选型、参数配置与效果验证
投机解码能把 LLM 推理的吞吐往上提一大截,但 vLLM 里方法有一堆、参数也不少。这篇按官方文档梳理清楚:各种方法适合什么负载、--speculative-config 该怎么写、用哪些指标判断到底有没有提速。
免费跑出 1500 token/s:Cerebras 上跑通 Qwen 3.8 27B 实操指南
阿里开源模型 Qwen3.8-27B 本周上架 Cerebras,跑出约 1500 token/s 的速度——比本地推理快一两个数量级,输入价格每百万 token 不到 1 美元,免费层每天送 100 万 token。本文用官方文档参数,带你从注册、配 key 到跑通第一个请求,并讲清楚 reasoning 控制、图像输入和速率限制这些坑。
浏览器主线程为什么贵?一份系统的前端性能指南:拆、批、排、延、绕
从'代码不慢,只是恰好占着主线程'出发,系统讲解浏览器主线程的运作机制与帧预算,给出五大优化策略:拆分长任务、批处理高频事件、优先级队列、延迟非必要工作,以及把工作移出主线程(合成器线程、Worker)甚至直接消除。每个策略都附代码与交互示例。