llama.cpp 还是 vLLM?2026 年本地 LLM 推理引擎选型指南(附实测基准)
Red Hat 工程师用 Llama 3.1 8B 在单张 H200 上实测了两个主流推理引擎:64 并发下 vLLM 吞吐是 llama.cpp 的 44 倍,但 llama.cpp 在消费级硬件上依然是唯一选择。本文把量化、GGUF、PagedAttention、连续批处理讲清楚,附完整选型决策树。
后端、跨平台、AI编程
Red Hat 工程师用 Llama 3.1 8B 在单张 H200 上实测了两个主流推理引擎:64 并发下 vLLM 吞吐是 llama.cpp 的 44 倍,但 llama.cpp 在消费级硬件上依然是唯一选择。本文把量化、GGUF、PagedAttention、连续批处理讲清楚,附完整选型决策树。
断网也能用的编程 Agent:用 llama.cpp 在 Mac 上跑 Gemma 4 26B,配合 MTP 投机解码把生成速度从 58 提到 72 token/s,再接上支持图片输入的 Pi 终端 Agent。
一个 OSINT 挑战的硬核解法:从照片里三块陆地的相对几何构建指纹,用 8000 万个三元组在全球海岸线数据上跑 CUDA 暴力匹配,再叠加密度、形状、植被、海拔七道筛选,最终锁定密克罗尼西亚的度假村。
jamesob 公开了他本地运行顶级大模型的全部经验:2 千美元预算用双 RTX 3090 跑 Qwen3.6-27B,4 万美元上 4×RTX 6000 Pro 跑 GLM-5.2-594B。包含完整的配置命令:BIOS 分叉、ACS 关闭、功率限制、vLLM 部署。
DuckDB 官方发布了 v2.0 预览:服务端模式、VARIANT 类型、触发器、全新 SQL 解析器、存储格式升级——10 个新特性带代码示例逐个讲清楚。
不满足于让 AI 解释概念,作者让 LLM 把复杂主题做成 RollerCoaster Tycoon 风格的模拟小游戏,边玩边学。本文还原他的完整流程:建知识库、审核、生成模拟、部署,以及进阶玩法。
手把手把 Qwen3.8-27B 跑起来:硬件要求、量化档位怎么选、Ollama / llama.cpp / vLLM 三条路线完整命令,以及 262K 上下文的坑。
同态加密让服务端能在密文上直接做计算,用户数据不泄露给服务商。Google 的 HEIR 编译器能把预训练模型自动转成支持密文推理的版本。本文拆解原理、架构和四个官方 demo。
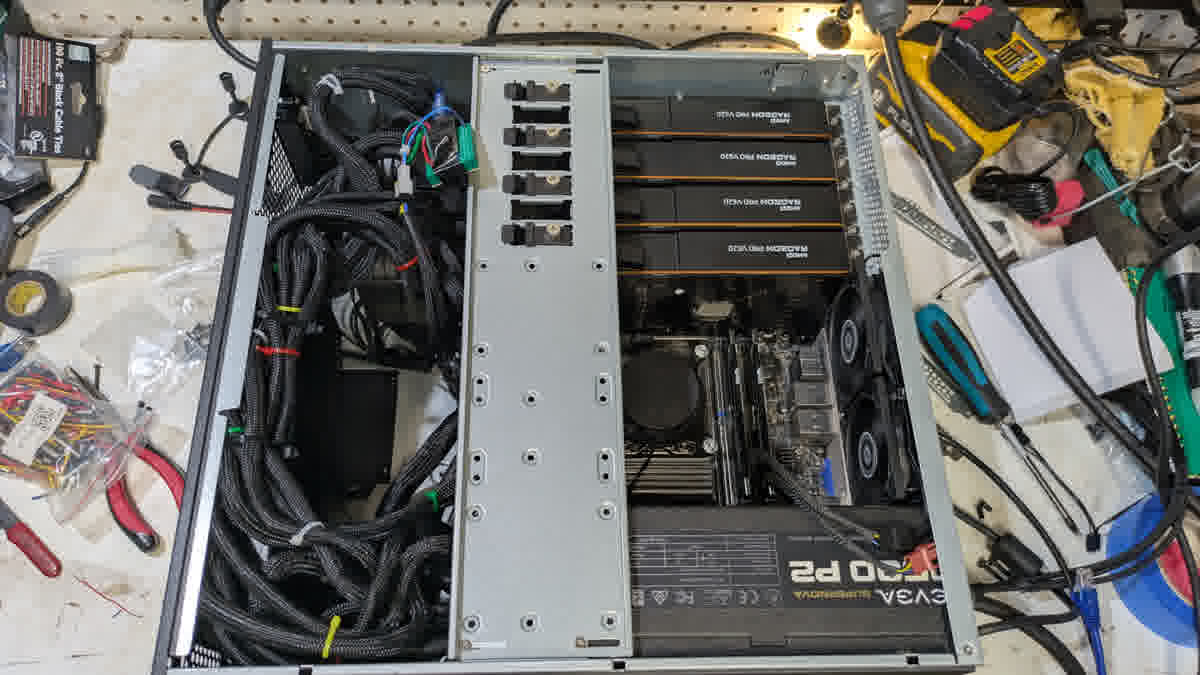
四块 32GB 显存的 AMD V620 云游戏退役显卡、2017 年的 X299 主板、Intel 最差 CPU——作者用几百美元的 e-waste 攒了一台本地 AI 服务器,还 3D 打印风扇导流罩、用 Arduino 自制了温控。
SQLite 3.7.0 到 3.51.2 存在 WAL-Reset 竞态 bug,特定条件下导致数据库静默损坏,Tailscale 半年踩坑 19 次。本文教你检查 SQLite 版本、确认是否受影响,并安全升级到修复版本。
Apple 的 Virtualization.framework 会给 macOS 虚拟机里的虚拟 GPU 上报保守的 Metal 能力,导致 llama.cpp 只能走慢速 GPU 路径。用 Cua 开源的一个进程级 shim,可以把提示处理速度提升 7-11 倍、token 生成速度提升 8-16 倍。
手把手教你把 llama.cpp 起的本地模型接入 OpenClaw:安装、启动 OpenAI 兼容服务器、写配置、配混合 fallback,所有参数来自官方文档,抄完就能用。