工具推荐
工具推荐
独立开发者+AI工具评测
共 118 篇RSS
Cua:给 AI agent 一台能用的电脑,把 Computer Use 变成可评测的工程
从跨系统的云桌面集群、能在后台操作原生应用的驱动,到专门判断界面上该点哪里的小模型,Cua 把 Computer Use 拆成了可以安装、可以打分、可以拿来训练的几块。
Ordewell:把一个目标拆成一张编码 agent 任务图,每个任务都能单独指定模型
多数编码 agent 是「一个模型一路干到底」。Ordewell 把目标先变成一张任务图,每个任务单独指定 runner、模型和思考强度,完成的判定不看模型自我评价,只看会话输出里有没有出现约定的完成标记。
Cloudflare 开源了一套安全审计 Skill,让编码智能体自己去挖漏洞
把一套六阶段的审计流程写成 Skill 交给编码智能体:侦察、按覆盖率猎取、候选验证、结构化输出、独立复核、出报告。核心规则只有一条最狠——验证漏洞的智能体,绝不能是发现它的那一个。
同一个模型换个 harness,成本最多差 5 倍,成功率几乎不变
Berkeley 团队把 7 个模型分别配 3 个 harness(Claude Code、Codex CLI、Pi)共 21 种组合,在 SWE-bench Lite 和 Terminal-Bench 2.0 上各跑 30 道题 × 3 遍:换 harness 对成功率的影响只有 ±2%(Terminal-Bench 2.0 上约 ±5%),成本却最多差 5 倍,SWE-bench Lite 上 Claude Code 平均是 Pi 的两倍。
OpenResearch:把 Claude Code 变成研究智能体,登顶 GitHub Trending 榜首
alphaXiv 团队开源的本地优先科研工作台,用 Rust 写:每个研究方向分配独立的智能体和 git worktree,实验、日志、产物全部留在本机,支持 Claude Code、Codex、OpenCode、Cursor 四种智能体。
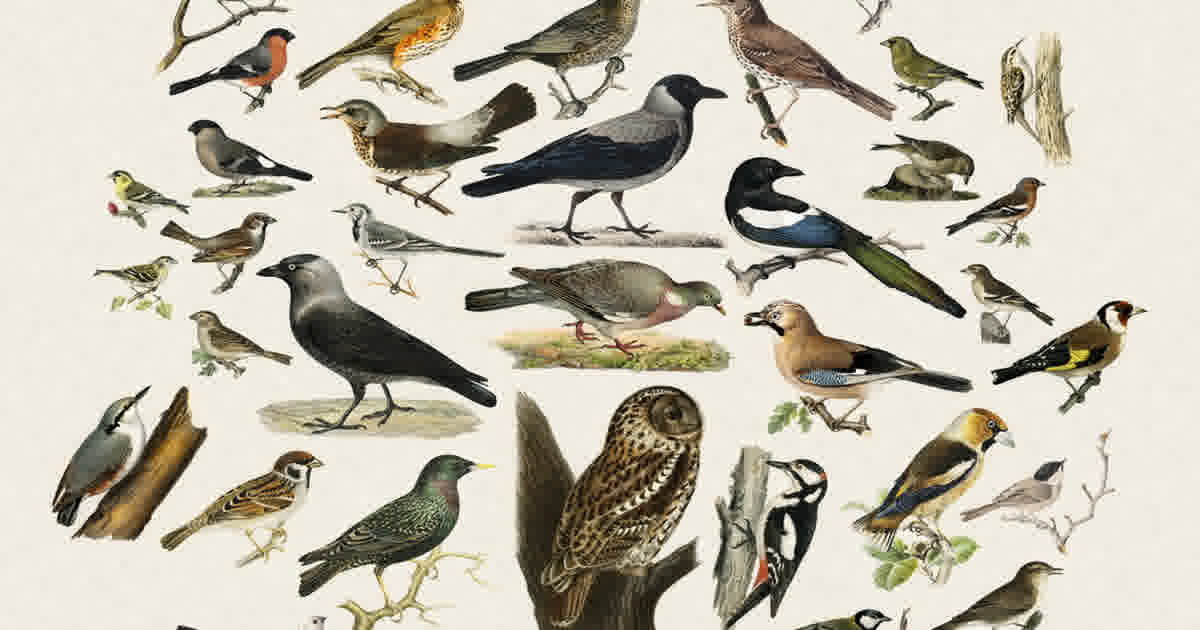
听见什么鸟就画什么鸟:树莓派加本地 AI 做的电子墨水鸟谱相框
麦克风听到鸟叫,本地模型识别物种,再从 800 多张公有领域与 CC BY-SA 授权的博物插画里挑一张画到电子墨水屏上。全程离线,不用一张 AI 生成图,1000 多颗星的开源项目。
阿里开源 Open Code Review:确定性流水线 + LLM Agent 的代码审查工具
阿里巴巴把内部用了两年的 AI 代码审查助手开源了:确定性流水线负责文件筛选、打包和行号定位,LLM Agent 负责动态决策,官方称在自建基准上比通用 Agent 精度更高、token 消耗约为其 1/9。
Chrome DevTools MCP:让 AI 编程助手直接操控浏览器做调试
谷歌官方开源的 chrome-devtools-mcp:把 Chrome DevTools 的完整能力通过 MCP 交给 AI 编程助手,用于性能分析、网络调试和浏览器自动化。

Superpowers:28 万星的 Agent 技能框架,让 AI 编程助手按软件工程方法论干活
Superpowers 把一套完整的软件开发方法论做成了可组合的技能包,装进 Claude Code、Codex、Cursor 等各种编程助手。它的核心不是让 Agent 多写代码,而是让它在动手前先问清楚、写计划、按 TDD 走。
Stockfish 19 发布:Elo 最高涨 44 分,神经网络砍掉冗余威胁特征
开源国际象棋引擎 Stockfish 发布第 19 个主版本:新 NNUE 网络 SFNNv16、通用二进制、RISC-V 与 LoongArch 原生支持,对上一代最高涨 44 分 Elo,代码和权重依旧免费。
近 1.7 万次实测:Claude Code、Codex、Cursor 会为你的项目选哪家服务?
Armature 团队跑了 16,893 次真实编码会话,观察三个主流 AI 编程代理会为你的项目选哪家数据库、支付、邮件和部署服务。结果:三个代理意见一致的场景只有 42%,Stripe 十局赢九,PayPal 被提到 139 次一次没被选,LangChain 被提 194 次只被选中 4 次。对独立开发者和工具厂商都是重要情报。
Polars 2.0 RC 发布:所有 LazyFrame 查询默认走流式引擎,内存大降、性能预期 5 倍提升
Polars 2.0 首个候选版发布:LazyFrame 查询默认改用流式引擎,多数查询内存占用和性能大幅改善,团队预期整体 5 倍提升;同时全面收紧类型行为——数据不匹配直接报错而不是静默出错,还新增了会告诉你迁移路径的 AttributeRemovedError 异常。