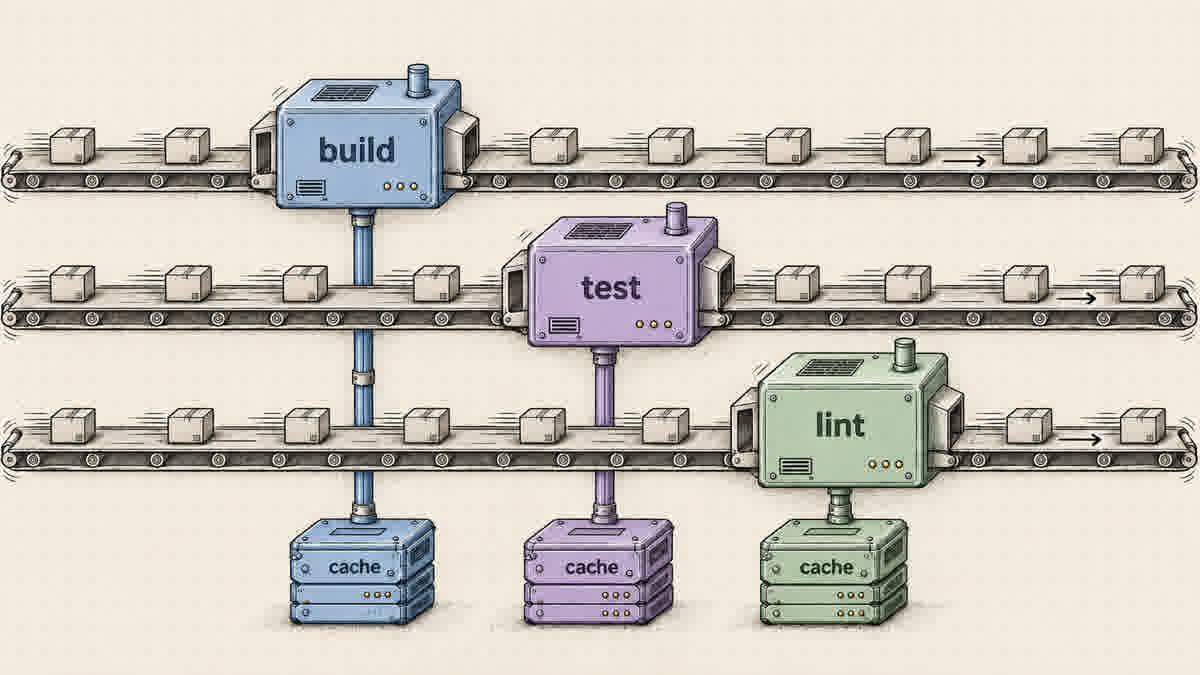
换掉官方 actions/setup-go,Go CI 测试耗时缩短 69%
CloudX 团队发现官方 actions/setup-go 的缓存 key 设计有缺陷:并行任务会互相覆盖缓存,测试任务因此越跑越慢。他们重写了一个 drop-in 替代品并开源,测试任务中位耗时从 131 秒降到 41 秒。
原文来源:CloudX — CloudX 团队拆解官方 actions/setup-go 的缓存 key 缺陷,用 Go 自带构建缓存的思路重写了一个替代品并开源,测试任务耗时下降 69%。
如果你们的 Go 项目 CI 越跑越慢,而且每次都要重跑一堆没改过的测试,问题可能不在你的代码,而在 actions/setup-go 的缓存 key 设计上。CloudX 团队把自己的排查和修复过程完整写了出来,代码也开源成 cloudx-io/setup-go。
先看症状
CloudX 的目标是:任何一次 push,90 秒内拿到明确结论——能不能编译、测试过不过、有没有违反 lint 规则。
去年他们遇到一个具体问题:并行的 lint 任务保存了一份不含测试结果的 Go 缓存,随后测试任务的中位耗时从 76 秒一路涨到 180 秒。这些多出来的时间不产生任何价值——它只是在重跑上一次已经跑过、代码完全没变的逻辑。
—— 广告 ——
根因:缓存 key 太粗
官方 action 的默认缓存 key 长这样:
setup-go-${os}-${arch}-go-${goVersion}-${hashFiles('**/go.mod')}
问题在于这个 key 覆盖的变量太少。正常开发过程中,绝大多数提交既不改操作系统、不改架构、不改 Go 版本,也不动 go.mod。也就是说,key 长期不变——第一个任务算出来的 hash 决定了后续所有任务加载哪份缓存。
于是会出现两个连锁反应:
第一,缓存逐渐过期。 第一次任务把当时的最终缓存状态写进 GitHub 缓存服务后就固定不动了。而随着你的业务代码持续变化,这份缓存能复用的部分越来越少:构建要重新做,测试要重新跑。CI 会一直劣化,直到你某天改了 go.mod。
第二,并行任务互相抢写。 lint、test、build 三个任务拿到同一个 key,同时往里写不同的本地缓存状态。谁先跑完谁赢,它的那份状态就成为后续任务加载的缓存。上面那个 76 秒变 180 秒的事故,就是 lint 先跑完、把不含测试结果的缓存写进去导致的。
补一句 actions/cache 的机制,这解释了为什么抢写会这么致命:一旦某个 key 下写过一份数据,这个键值对就不可变了,后续任何想写不同值到同一个 key 的调用都会被拒绝。所以并行任务里,先到的那个决定了所有人的命运。
Go 的缓存本身没问题
Go 工具链自带缓存,设计其实很讲究:
| 缓存 | 控制变量 | Linux 默认位置 |
|---|---|---|
| 模块缓存 | GOMODCACHE | $GOPATH/pkg/mod |
| 构建缓存 | GOCACHE | ~/.cache/go-build |
| 测试缓存 | GOCACHE | ~/.cache/go-build |
构建和测试缓存共用 GOCACHE 目录,目录里以 -d 结尾的是数据载荷,-a 结尾的是索引。两者的共同点是:把完整的输入做 hash 当 key,只要输入没变就直接复用输出。测试缓存尤其聪明——Go 的测试运行器会盯着测试进程,自动记录它读了哪些文件,把这些文件内容也算进 cache key。
问题出在 GitHub Actions 的环境上。CI runner 是一次性、无持久磁盘的,所以要靠 actions/cache 把工具链缓存"偷渡"到下一个 runner。而 actions/cache 的设计优先事项和 Go 的缓存完全不同——它是按 key 存整块缓存文件(blob),key 不变就永远加载第一份。两套机制一叠,Go 那边精心设计的增量复用就废了。
修复思路
CloudX 的做法是让"精确命中 key"变成不可能事件,新的 key 加上 ref_name、run_id 和基于 go.sum 的 hash:
go-cache-${os}-${inputs.cache-key-prefix}-${goVersion}-${ref_name}-${hashFiles('**/go.sum')}-${run_id}
run_id 保证了每次任务结束都会写入一份新 blob,不会再有任务被迫加载十天前的陈旧状态。不同 job(lint / test / build)用不同的 cache-key-prefix,从根上消除抢写。
怎么在自己的仓库上验证
以下是编者根据原文复盘整理的落地顺序。原文只给了自家仓库的测量数字,以及一句"中等复杂度的项目可以期待类似提升",没有分步流程。
在动手换之前,建议先量化,不然你没法判断值不值得。
第一步,看清你们的 job 结构。 打开 CI 配置文件,数一下有几个并行 job 会调用 actions/setup-go。只有一个 job 的话,抢写问题不存在,收益主要来自"缓存永远新鲜"那一半;有三个以上(lint、test、build 分开跑)的话,抢写就是实打实的问题。
第二步,看 test job 的中位耗时。 GitHub Actions 的运行记录里可以直接看到每个 job 的耗时。只看 test job,记下中位数和波动范围。官方的缓存方案会造成"越跑越慢然后突然恢复"的锯齿形曲线——如果你看到这种形状,基本可以确认是缓存 key 的问题。
第三步,估一下改 go.mod 的频率。 收益和这个频率成反比:一个月才改一次 go.mod,缓存能连续很多次运行保持同一份 key,过期效应就非常严重;如果你们天天加依赖,key 换得勤,反而没那么多劣化空间。
第四步,先在一个非核心仓库试。 把 action 换掉跑上一段时间,对比 test job 的中位耗时。同时盯一下缓存用量有没有超额度——这是唯一需要额外花钱的地方,提前看清楚比重构完才发现要好。
第五步,记得处理缓存膨胀。 作者明确说了要靠自动裁剪解决,这一步不能省。如果 CI 里缓存下载耗时占比明显升高,说明该清了。
这几个数字——并行 job 数、test job 中位耗时、go.mod 修改频率、缓存用量——大致决定了这次改造对你们能拿到多少收益:可能只有几个百分点,也可能接近七成。原文的数据来自一个有多个并行 Go job 的 monorepo,属于收益比较理想的情形,照搬之前先确认自己的场景是否接近。
效果
这里的两个耗时口径都来自原文,统计范围不同:事故期的文字描述是 76 秒涨到 180 秒,图表标注的修复前后对比是 131 秒降到 41 秒。
- 测试任务中位耗时:131 秒降到 41 秒,降幅 69%
- 在最新的 4,011 次提交上建模对比:官方 action 需要 526,166 次测试包运行,新方案只要 71,928 次,减少 86%
- 即使你把 lint 和 test 串行跑,新方案依然更快,因为它每次运行后都会保存更新过的缓存
两个需要注意的副作用
作者很诚实地列了代价,换之前先想清楚:
缓存会长得很快。 Go 的缓存不会自动清理,你不清它就一直涨。新方案保存得更频繁,所以膨胀得更快。他们后来加了自动裁剪才解决。如果 CI 里出现缓存加载时间占比变高,先查这里。
可能需要扩容 GitHub Actions 缓存额度。 存的对象变多了,额度可能不够。这部分成本能被更短的 job 时间抵消——runner 是按分钟计费的,但要在 GitHub 里找到对应的设置项确实费劲。
这个方案在 CloudX 内部从去年 11 月稳定用到现在才开源。对管理中等复杂度 Go 项目的人来说,替换成本很低——它是一个 drop-in 替代品,把 uses: actions/setup-go@vX 换成对应的 action 就行。先在小仓库上验证一遍,看你们改 go.mod 的频率有多高——改得越少,收益越大。
© 2026 四月
原文链接:https://www.aprilzz.com/tutorials/go-ci-cache-setup-go
相关文章
从 2500 亿条缓存里抠出 100TB 内存:Cloudflare 的五个内存优化手法,每个都能直接抄
Cloudflare 对 1.1.1.1 的 DNS 缓存做了 5 个存储层优化,每条目占用从 953 字节降到 420 字节,整个机群省下约 100TB 内存,缓存反而更快了。本文逐条拆解这些可复用的 Rust 内存优化技术。
Go 泛型中的 GC Shape Stenciling:性能与编译速度的平衡艺术
深入理解 Go 语言如何在泛型实现中通过 GC shape stenciling 平衡编译速度与运行时性能
vLLM 投机解码实战:方法选型、参数配置与效果验证
投机解码能把 LLM 推理的吞吐往上提一大截,但 vLLM 里方法有一堆、参数也不少。这篇按官方文档梳理清楚:各种方法适合什么负载、--speculative-config 该怎么写、用哪些指标判断到底有没有提速。