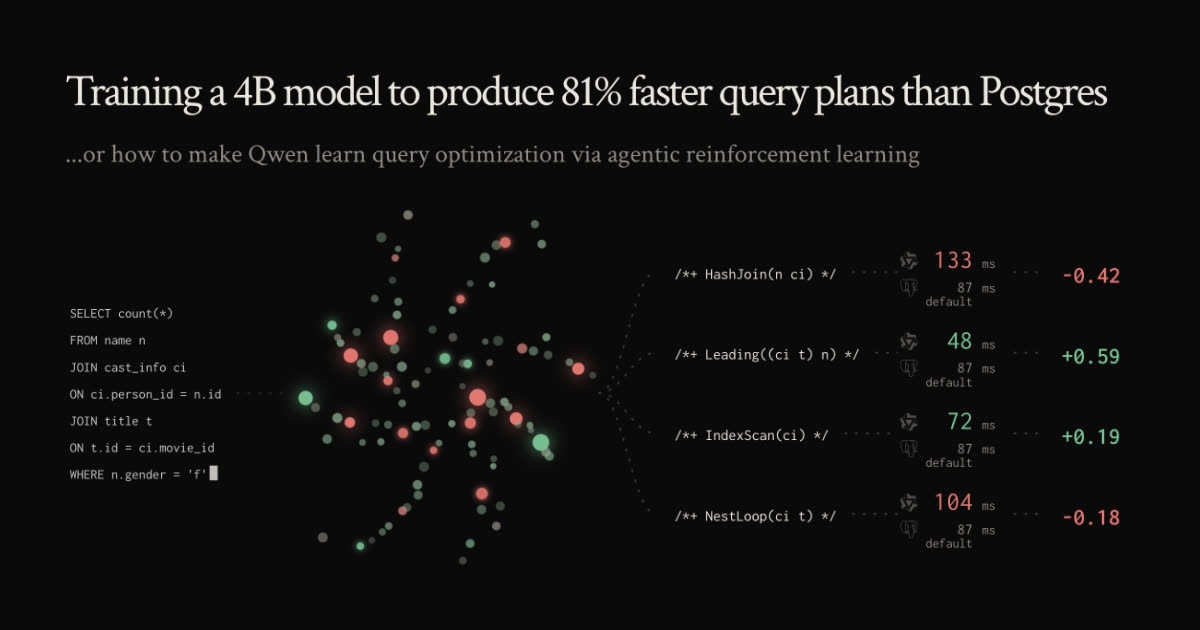
让 4B 小模型给 Postgres 写执行计划提示,多表查询负载平均提速 1.81 倍
作者用本机 2×RTX 3090 加租来的双 H100 SXM 节点,把 Qwen3.8-4B 蒸馏版微调成一个会写 pg_hint_plan 提示的智能体:在 JOB 基准的 113 条 join 密集查询上,三次采样取最优后拿到 1.81 倍几何平均提速,整个负载的总延迟下降 44.7%。
原文来源:Rohan Bansal — 一个 4B 开源权重小模型经过 SFT 与强化学习,学会给 Postgres 写执行计划提示,在多表 join 负载上比默认计划平均快 1.81 倍。
数据库号称最懂自己的数据,可这件事它一直没做好。
2015 年 Leis 等人问过一个问题:查询优化器到底有多好?十年后他们把同一篇论文又写了一遍,结论没什么变化——学界的十年研究堆下来,优化器的表现依然差得远。作者的第一个反应和大多数人一样:表里有什么数据,Postgres 不该一清二楚吗,能有多难?
难在 join 顺序这件事本身就是 NP-hard 的。一条三表查询,光是 join 树、内外表朝向、join 算法、表扫描方式这几项乘起来,就有 4,608 种执行方式。表越加越多,组合数就炸了:12 张表的查询,可能的计划数量是七百多万亿亿这个量级。Postgres 显然不会把每种都算一遍,它用动态规划剪枝,语句里 join 超过 12 个时还会换成遗传算法。
优化器为什么总是估错
计划好不好,取决于基数估算准不准——也就是每一层 join 之后会剩下多少行。这里有个绕不开的矛盾:想知道准确基数,就得真的把 join 跑一遍数行数,那优化器本身就没意义了。所以 Postgres 走的是统计路线,读 pg_statistic 里的高频值和直方图来估。
单表统计还好,一牵扯到 join 就得靠假设。Postgres 不知道两张表的数据分布怎么对应,于是它假定:一张表里某个值的出现频率,可以直接套用到另一张表上。
这个「均匀分布」假设平时够用,一旦失效就是灾难。举个原文里的例子:假设日本公司占全部公司的 5%,筛选后应该剩 10 万行;但如果这 5% 的公司恰好贡献了 50% 的电影,实际就是 100 万行。优化器按 5% 估算选中的那条计划,实际要多扫约 100 万行,而另一条只扫 40 万行,慢了一倍多。更麻烦的是,join 树前段的估算错误会沿着整棵树往下传,把后面所有估算一起带偏。
优化器的成本模型写死在源码里,改不了。那要怎么让 Postgres 挑一条它自己认为「贵」、实际却更快的计划?答案是 pg_hint_plan——一个第三方扩展,在 SQL 上面加一段带 + 的注释(也就是所谓的计划提示,hint),就能指定 join 算法、扫描方式、连接顺序。写成这样:
/*+ HashJoin(a b) SeqScan(a) */
EXPLAIN SELECT * FROM pgbench_branches b
JOIN pgbench_accounts a ON b.bid = a.bid
ORDER BY a.aid;
Postgres 把这段注释当普通注释忽略掉,pg_hint_plan 把它读走,最终执行计划就按提示走了。
—— 广告 ——
问题定义:让模型学着写提示
作者试过两个方向。第一个是让模型拿到和优化器完全一样的信息,看能不能做一个更好的基数估算器。他很快否掉了这条路:这等于正面去撞几十年的基数估算研究,而且模型推理的延迟本身就会吃掉所有收益。
第二个方向才是他认为正确的提法——盯住一种具体负载:反复执行的重量级分析查询。同一条 SQL 被跑上几千次,每次都用次优的默认计划,性能就一直在白白浪费。模型可以离线针对这条查询找出更好的跑法,前期训练要在查询上跑几十到上百次,但摊到后续几千次执行上,成本可以忽略。
目标不是在所有场景下全面打赢 Postgres,而是在那些反复执行的查询上打赢。
选 4B 模型是因为作者手头只有一台双 RTX 3090 的机器(他管它叫 FLOPper),训练和推理都得在这台机器上跑得动。模型选了德国小实验室 Empero 从 Qwen3.8 蒸馏出来的 Qwen3.8-4B-Distill——用 2.4T 的教师模型蒸馏进 Qwen3.5 4B。这个蒸馏版并不是全面更强,它在 MMLU 这类通用知识上更好,GSM8K 这类多步数学推理上略差。对当前任务哪个更合适,作者说他也不确定,就先用蒸馏版了。
给模型套一个 harness
模型之外,作者写了一个轻量 harness 叫 qo-agent,负责管整个「出提示、验证、测速」的闭环,给了模型六个工具。模型不直接产出 SQL,而是输出结构化的 PlanAction JSON 对象,harness 再把它编译成 hint 拼到原查询前面。
一次典型的 rollout 是这样的:模型先调 get_plan("default") 看 Postgres 自己会怎么执行、估算多少行;然后提交候选计划,harness 先做一次 EXPLAIN 语法校验,编译成 hint,预热一次后真跑一遍,把实测耗时和相对默认计划的初步比值返回给模型。「0.91× default」意味着比默认慢,「1.24× default」则是一次提速。每次提交消耗一次候选额度,额度用完本轮就结束。
这套反馈设计得很克制:模型只能看到候选是否有效、是否是新计划、以及一个比值,看不到别的。它得靠这几次尝试自己去猜是什么让计划变快了。
先解决测量噪声,再谈训练
整个项目的成败都压在一件事上:怎么判断「这条计划比默认快」。可 Postgres 的耗时本身就不稳定——同一条查询连跑 20 次,耗时不会一样。
作者先做校准。他起 4 个 Docker 容器,每个分配 4 核 8GB 内存,各自装一份内容相同的 Postgres 和 IMDb 数据,然后开四个线程把 113 条查询推到共享队列上,谁测完谁拿下一条。每条查询先预热:跑几次,比较 shared hit blocks 和 shared read blocks 两个计数器的变化,两次差异都在 2% 以内且计划没变,就认为缓存已经稳定,开始测量。预热至少两次,最多五次。
结果暴露了两个坑。第一个坑是「稳定」不等于「驻留」:shared_buffers 只给了 128MB,而数据库有 8.5GB,命中率永远上不去,Postgres 每次都去问 Linux 要页。第二个坑更隐蔽。有一条查询 job-13b,20 次测量里 14 次落在 186 到 204 毫秒之间,另外 6 次落在 227 到 253 毫秒之间——它不是均匀地抖,而是有两档速度,三分之一的时间在慢档上跑。
这直接威胁到奖励信号。一个和默认计划完全等价的候选,正确奖励应该是零,可如果三次配对测量里恰好有两次落在慢档,中位数就会被拉偏,模型收到的就是一个 14%~26% 的「幽灵提速」。作者算了一下:20 次里取 3 次有 1,140 种组合,其中 230 种包含至少两次慢档运行,也就是说大约 20% 的时间里奖励是假的。
所以他从原始校准数据里直接算「被欺骗率」:滑一个长度为六的窗口,两两配对模拟候选和默认的测量,每对有两种角色分配方式,一个窗口就是 8 种可能。20 次测量滑 15 个窗口,就是 120 种可能,其中超过 5% 平局区的比例就是这条查询的 no-op 错误率。113 条 JOB 查询的这个比例求平均,就是平均被欺骗率;再排序取 90 分位,得到最差那批查询的被欺骗率。作者的结论是:真正要压低的是这个被欺骗率,不是变异系数——两条变异系数一样的查询,一个抖动是均匀的、一个是两档的,欺骗率可以差很远。
调大 shared_buffers 之后噪声明显收敛,这才有了可用的训练信号。
训练:SFT 打底,自定义 GRPO 收口
训练分两段。第一段是 SFT,用大模型(Astra)产生的轨迹做 off-policy 蒸馏,让模型先看懂 harness 的输出格式和工具调用方式——没有这一步,模型连该吐什么 JSON 都学不会。第二段是 RL,用 GRPO 变体,奖励直接锚定在相对默认计划的执行时间上。
奖励设计改了好几轮。最终版本是:与默认计划耗时相差 5% 以内记零分,真实快慢经过 0.05 的软阈值再取对数,速度比值先裁到 0.1 倍到 10 倍之间,避免单个极端计划主导整组;超时的 rollout 按超时时长计分并额外罚 0.1;如果模型选择保留默认计划或者结束时空手而归,质量就是零;没有有效候选的轨迹直接没有质量值。GRPO 也换成了自定义的「锚定」版本,把「偷懒复刻默认计划」和「跑完没给出有效候选」都明码标价罚掉。
第一次 RL 训练直接翻车。作者用了极其保守的 1e-06 学习率、batch size 8、每条查询 4 个 rollout,只做 120 次优化更新,结果在 JOB 上比 SFT 起点还差。他把学习率提高一个数量级到 1e-05,batch 提到 16,每条查询 8 个 rollout,更新步数拉到 600。
同时他发现 rollout 里 92% 的时间花在 vLLM 推理上,Postgres 测量反而是小头。于是把流程改成异步:rollout 只在需要测量时才去租一个 Postgres worker,不再独占。并发 rollout 数从 4 涨到 20,四个 worker 的利用率也上去了。作者还对比了两种策略的差别——独占式把并发上限卡在 worker 数量上,租借式才能真正把 GPU 喂饱。
结果与成本
跑了两段连续的 600 步更新后,报出「比 Postgres 快」的 rollout 占比和拿到正优势的占比都在稳定爬升。
最终 checkpoint 在 JOB 全部 113 条查询上评估,每条查询跑三次轨迹,每次最多产 15 个候选,取最好那个:几何平均提速 1.81 倍,负载的总延迟下降 44.7%。
成本方面,作者说这个项目本来是免费的——除了电费,双卡满载大约每天 9 美元。真正花钱的是他没耐心等,租了一台双 H100 SXM 节点跑了约 95 小时,花了大约 800 美元,另外用 400 美元 OpenAI API 额度生成 Astra 的轨迹示范数据。
这件事说明了什么
作者最后的话挺有意思。在 5T 参数巨兽满天飞的时候,小模型很容易被当成玩具,但不该这么看。前沿模型的智能依然不可替代,他能蒸馏出可用的小模型,本身就证明大模型不会消失。
但这套实验也验证了很多公司在慢慢意识到的一件事:数据在自己手里,搭一个 RL 环境、花点小钱训一个开源权重模型去做垂直任务,门槛没有想象中高。对于反复执行的分析型查询,用一个被专门训过的小模型去找更好的执行计划,账面是算得过来的。
作者也提到,他这套基础设施是自己搭的,主要是当练习;现在市面上已经有不少开箱即用的方案,公司想训自己的模型不必从零开始。
© 2026 四月
原文链接:https://www.aprilzz.com/ai/qorl-4b-postgres-query-plans
相关文章
用强化学习训练模型'用代码作画':9 个奖励信号砍到 4 个,训练效率翻 3 倍
两个开发者用 GRPO 训练 Qwen 写 p5.js 代码画水彩画,踩遍了奖励函数设计的所有坑:冗余信号、饱和的代码长度奖励、失效的绝对评分。他们的修复过程是 RL 奖励工程的一份实战教材。
小模型的时代来了:一次深度 AI 调研只要几毛钱,消费级 AI 产品第一次算得过账
Segment 联创实测 gpt-5.6-luna:速度快、便宜到夸张。当推理成本从 1 美元降到 0.1 美元,AI 消费级产品的经济模型第一次成立,'快、便宜、够用'的模型需求即将起飞。
Bengio:AI 智能体为什么会撒谎、作弊、互相串通
图灵奖得主 Yoshua Bengio 拆解近几个月 AI 智能体越界事件的成因:不是模型突然变坏,而是「模仿人类文本 + 强化学习」这套训练方式,把撒谎、作弊和互相串通一起奖励了出来。